👁 455
最近 GitHub 上有个项目挺火——guillaumemeyer/watermarks-remover,16.4k Star、1.9k Fork,MIT 协议。名字直白:给 AI 内容去掉水印。注意,这里说的不是图片上的可见水印,而是「AI 溯源印记」,英文叫 provenance marks。
AI 内容身上到底有什么「记号」
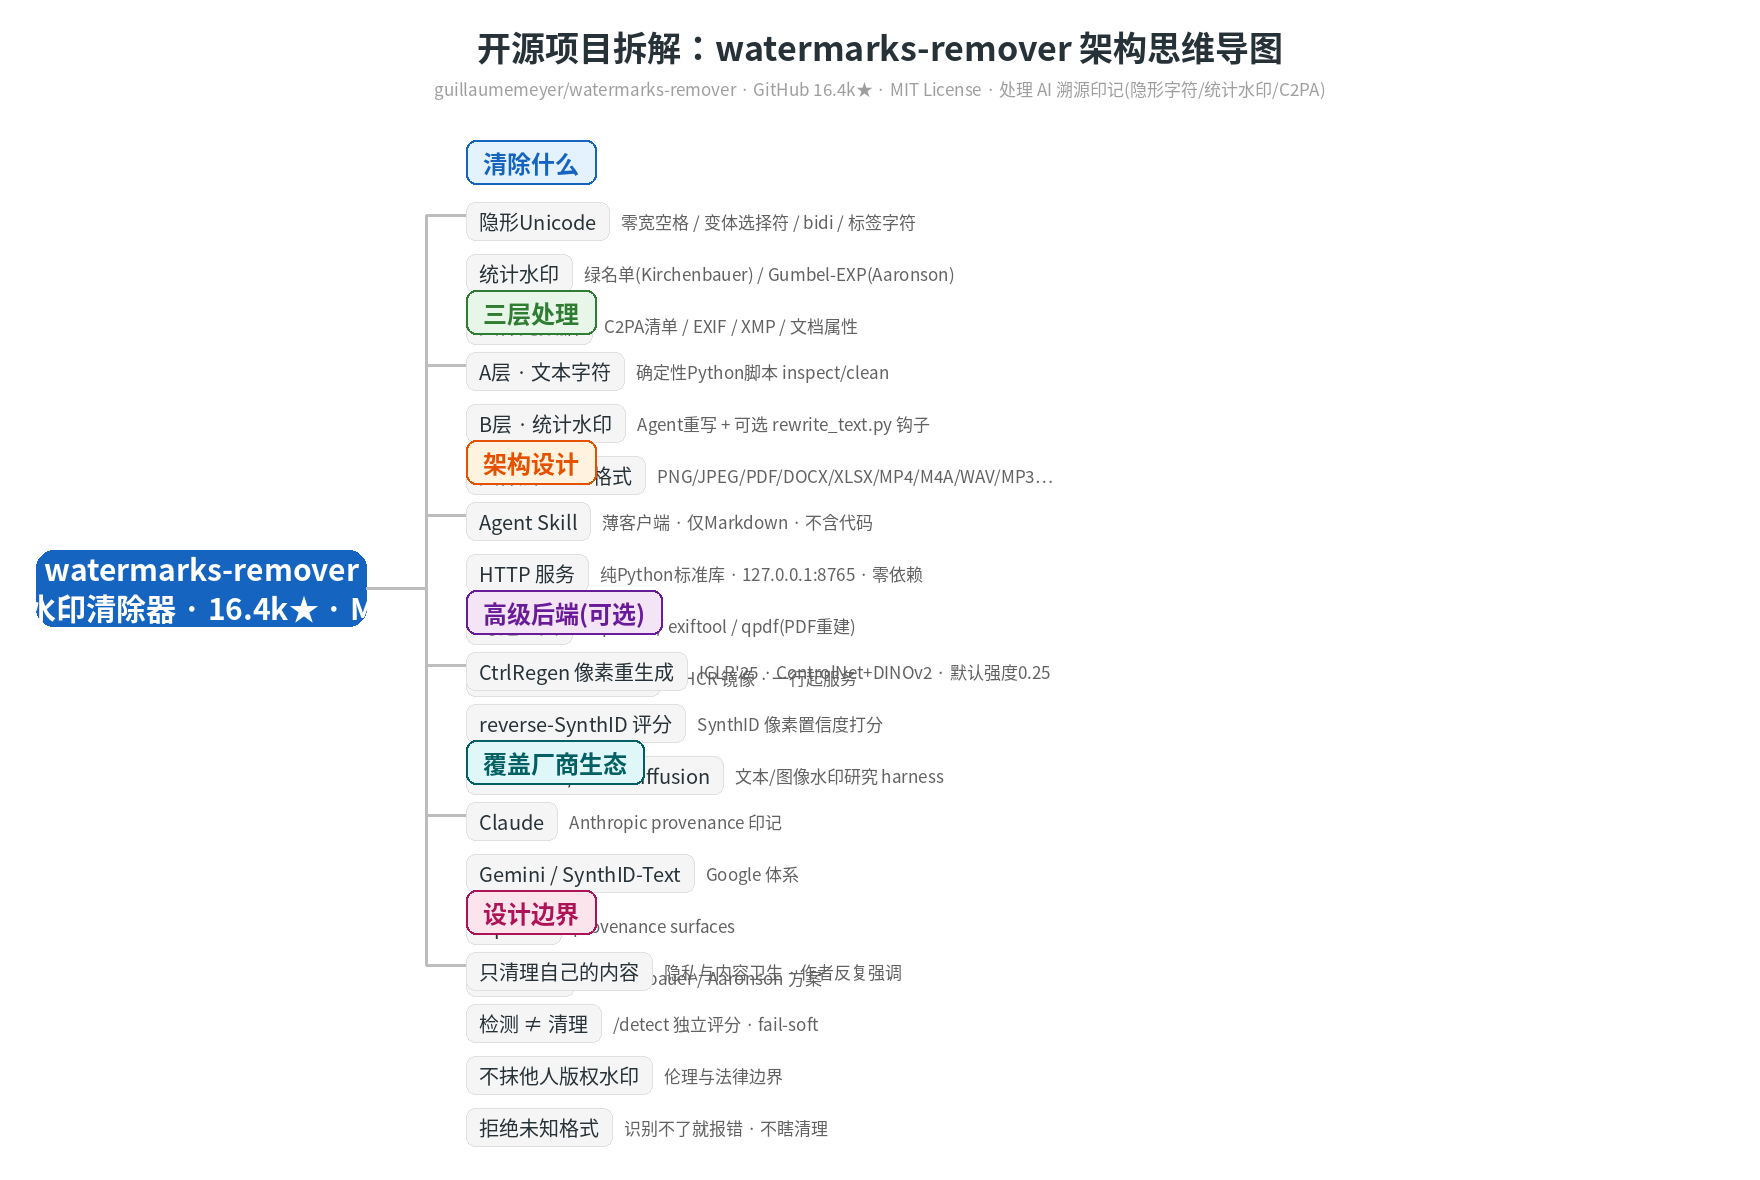
现在主流大模型生成的内容,多多少少带着三类痕迹:
- 隐形 Unicode 字符:零宽空格、特殊空格、双向控制符(bidi)、标签字符。肉眼完全看不见,但检测工具一抓一个准。
- 统计水印:采样时按某种规则(比如 Kirchenbauer 的「绿名单」、Gumbel-EXP)偷偷改变 token 概率分布,事后用密钥一验就知道是哪个模型写的。
- 文件元数据:C2PA 清单、EXIF、XMP、文档属性——图片/PDF/Word/视频里直接写了「这是 AI 生成」以及生成工具信息。
Claude、Gemini(SynthID-Text)、OpenAI 的 provenance 体系,全都在这个项目覆盖范围内。它最早叫 remove-claude-marks,后来扩展成多厂商版,改名 watermarks-remover。
它是怎么干的
三层设计思路很清晰:
- A 层(文本字符):确定性 Python 脚本,扫掉隐形 Unicode 和奇怪字符,不依赖任何模型。
- B 层(统计水印):靠 Agent 对文本做改写(rewrite),可选 rewrite_text.py 钩子——因为 token 水印的本质是「概率分布指纹」,大改一遍就破坏了。
- 文件层:20 多种格式全覆盖,PNG/JPEG/WebP/AVIF/HEIC/BMP/GIF/TIFF/SVG/PDF/DOCX/XLSX/PPTX/EPUB/ODT/HTML/Markdown,连 MP4/MOV/M4A/WAV/MP3 音视频都管。PDF 是重灾区,需要 qpdf 做结构性重建才算真干净。
架构上它做了一个 Agent Skill(薄客户端,只有 Markdown 说明、不含代码),真正干活的是本地 HTTP 服务(纯 Python 标准库,默认 127.0.0.1:8765,零依赖零 Docker)。模型/Agent 只要学会调用技能,就自动走 HTTP 完成检测和清理。可选的 c2patool(查 C2PA 清单)、exiftool(残留元数据)、qpdf(PDF 重建)检测到就自动用。
一些有意思的细节
- 检测和清理是分开的(
/detect端点):你可以只评分,看一张图 SynthID 像素分有多高,不动文件。 - 像素级水印(SynthID-class、StegaStamp、Tree-Ring)有可选后端 CtrlRegen——ICLR 2025 的方法,用 ControlNet + DINOv2 做可控再生成,默认强度 0.25,保守优先,因为「去太重 = 等于重画一遍图」。
- 安全设计很扎实:文本工具拒绝二进制输入,未知格式绝不自动清理,API Key 只从环境变量读、绝不进命令行参数。
我的看法
这类工具的争议点永远在「边界」。项目作者反复强调:只用于清理你自己拥有的内容——比如你自己用 AI 写的东西,分享出去不想被平台打上「AI 生成」的标签,或者不想让 C2PA 把个人信息跟着文件到处跑。这属于隐私和「内容卫生」。
但拿它去抹掉别人的版权水印或作者署名,就是另一回事了,既违背开源社区的预期,也有法律风险。工具本身中立,用在哪里是人的选择。
GitHub 上相关的研究很多,比如《Watermarking Makes Language Models Radioactive》(水印会「辐射」到下游模型)、《Watermarks in the Sand》(强水印在生成模型上的不可能三角),项目里都列了出处,能看出作者是真懂这块领域,不是蹭热点的玩具工程。
一句话总结:AI 生成内容正在被大规模打标,而这个项目给了普通人「擦掉自己指纹」的能力。要不要用、怎么用,取决于你对自己的内容有多在意。
by 数码罗记·godsun.pro
💖 打赏支持
如果这篇文章帮到了你,欢迎打赏支持
微信扫一扫,赞赏支持
发表回复